你有没有遇到过这种场景:网站在国内访问飞快,到了东南亚用户就卡成 PPT?或者某个时间段访问突然延迟爆炸、请求丢包严重,偏偏 traceroute 也看不出异常?这时候你可能意识到了——跨地域网络质量,本质就是一场“看不到的战争”。
但问题来了:怎么才能持续、自动化、无死角地监控这些跨境链路的真实表现?
答案是——构建一套真正实战可用的 RTT(Round Trip Time)+ 丢包率 多点自动检测系统。
为什么单点 Ping 已经不够用了?
我们先说个冷知识:运营商互联本身就像是在沙漠里修路,每条链路都会有不稳定的时段,尤其是国际线路。你现在拿 ping、traceroute 去测,只能看到某一个点到目标的结果,但你的用户可能来自全国乃至全球不同地区。
单点探测就像是你站在北京测了下“广州到东京”的路好不好走,这靠谱吗?
——当然不靠谱。
想真正搞懂链路质量,必须做到:
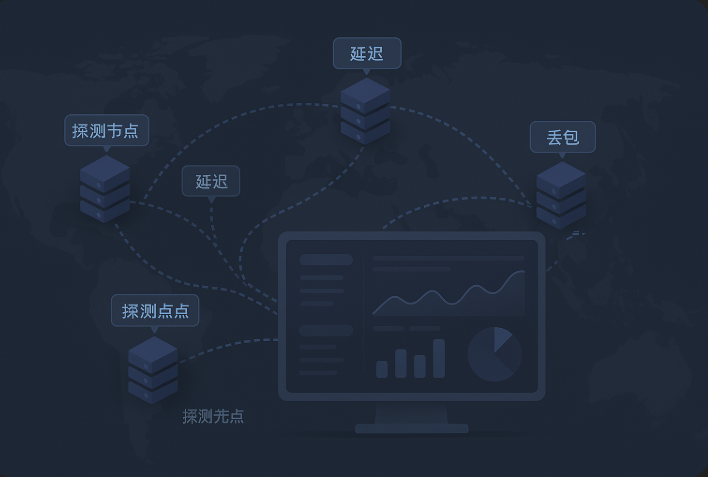
从多个地理位置(如华东、华南、亚太、北美)同时发起探测
定时、连续测量 RTT、丢包、抖动
支持历史数据分析和异常告警
最好还能可视化展示
这,才是跨境网络监控的正确打开方式。
构建自动化检测系统,需要哪些关键组件?
1. 全球探测节点布设
你得有多个“眼睛”,分别布在不同的地理区域。你可以用云服务器(比如阿里云新加坡、腾讯云硅谷)作为探测点,当然也可以混合使用自建 IDC 节点。
建议探测节点不少于 5 个,分布如下效果会更好:
中国大陆南方(如深圳)
中国大陆北方(如北京)
中国香港或台湾
东南亚(新加坡或越南)
北美(洛杉矶或硅谷)
2. 主动探测模块
每个探测点需要安装轻量探测 Agent,可用工具如:
fping:高性能并发 pingmtr:用于链路追踪 + 丢包探测tcping:模拟 TCP 连接情况自定义 HTTP 探测(检测网站响应质量)
这些探测程序会定时执行,比如每 60 秒采集一次,并打上时间戳、源 IP、目标 IP 等基础信息。
3. 数据汇聚与存储系统
探测数据太碎了,不能白采!你得把这些数据统一发送到一个中心系统,比如:
使用 Prometheus 拉取或接收探测指标
用 InfluxDB 存储时间序列数据(RTT、丢包率)
Kafka + ElasticSearch 用于日志和链路事件追踪(进阶)
每条数据要包括:
探测源节点标识(如 CN-BJ-01)
探测目标域名或 IP
探测时间
平均 RTT、最大 RTT、丢包率、连接成功率等指标
4. 多维度告警系统
光采数据还不够,出现异常时你要第一时间知道。你可以配置如下规则:
任意探测点丢包率 > 10%,持续 3 分钟,告警
平均 RTT > 300ms,持续 5 分钟,告警
同一个目标从多个探测点连接失败,等级提升为“红色”告警
推荐使用 Alertmanager + 企业微信/钉钉告警机器人,做到及时、直观。
5. 可视化仪表盘
数据展示是灵魂。不要再用那些黑框 ping 命令看结果了,Grafana 或自研大屏才是现代运维的标配。
仪表盘建议展示:
各区域 RTT 折线图 + 热力地图
各链路丢包率趋势图
异常历史记录 + 快速定位 IP 路径
这会让团队在看到“东京访问慢”的时候,不用争论就能知道是 “跨境链路丢包” 还是“目标机卡顿”。
这个系统能解决哪些实际问题?
一套好用的跨地域检测系统,不是为了“炫技”,而是为了帮你精准地识别真实问题,比如:
场景一:用户反映访问缓慢
传统做法:你从自己电脑 ping 一下,结果正常,但用户还是卡
现代方案:多点探测显示 “广州 -> 新加坡”链路 RTT 飙升到 800ms 且丢包 35%,问题立刻定位。
场景二:某区域流量异常下滑
传统做法:手动调日志、看访问数,可能都太慢
现代方案:系统实时告警“香港探测点连接丢包严重”,自动推送给运维负责人,快速响应。
场景三:跨境直播/游戏用户卡顿频繁
探测系统能帮你区分是客户端网络差、DNS 解析异常,还是跨境出口质量波动。
这种能力,才是真正对业务有价值的支撑。
多点探测 ≠ 贵,关键看设计
有人会说:这东西听起来好高级,成本不是很高吗?
其实未必。
你可以用最便宜的云服务器来布点,一个月几十块;探测程序轻量、不消耗资源;甚至可以和现有监控体系打通。
关键在于你愿不愿意去做这件事——做了,你就是主动防御;不做,永远只能被动挨打。
 豫公网安备41160202000677

