
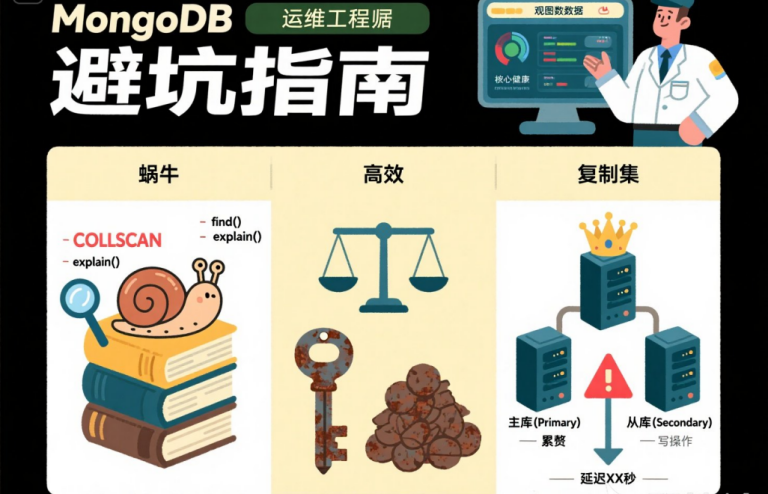
当咱们把MongoDB这位“NoSQL悍将”请进我们的技术栈时,往往是看中了它的灵活性和高扩展性。但一个未经精细监控和持续优化的MongoDB集群,就像一辆没经过专业调校的F1赛车,虽然天生底子好,但不仅跑不出应有的极限速度,甚至还可能在关键时刻“抛锚”在赛道上,让你措手不及。
“我的应用怎么突然变慢了?”“数据库CPU为啥又飙高了?”“主从延迟怎么这么大?”……与其在问题爆发后手忙脚乱地“救火”,不如从今天起,就学会如何当一个“预防大师”,通过持续关注一些核心的健康指标,把性能问题扼杀在摇篮里。下面,我们就来逐一拆解MongoDB性能监控中最需要“避开”的三大“天坑”!
第一大“坑”:慢查询(Slow Queries)——数据库性能的“无声杀手”
这绝对是导致MongoDB性能下降的头号“杀手”!一个慢查询,就像是数据库里的一颗“老鼠屎”,能坏了一整锅“汤”。它会长时间霸占CPU和内存资源,持有锁,阻塞其他正常查询,最终导致整个应用层面的连锁反应,用户体验直线下降。
如何监控与定位慢查询?
开启“慢查询日志”——MongoDB Profiler:MongoDB内置了一个强大的性能分析器(Profiler),可以帮你记录下那些超过指定时间的“慢操作”。
level=1:记录所有耗时超过slowms毫秒的操作。level=2:记录所有操作。slowms:就是你定义的“慢”的阈值,比如100(毫秒)。怎么开启? 在mongo shell中执行
db.setProfilingLevel(level, slowms)。开启后,所有的慢查询记录都会被写入到
system.profile这个特殊的集合中,你可以像查询普通集合一样查询它,找到那些“罪魁祸首”。用
explain()给查询“做CT”——分析执行计划:找到了慢查询的语句,接下来就得给它做个“深度体检”,看看它到底慢在哪儿。explain()就是你的“CT扫描仪”。executionStages.stage: 如果这里出现了COLLSCAN,恭喜你,你中奖了!COLLSCAN代表全集合扫描,意味着MongoDB为了找到你需要的数据,不得不把整个集合从头到尾翻了一遍。这就像让你在没有目录的《新华字典》里找一个字,能不慢吗?这是性能的大忌!我们最希望看到的是IXSCAN(索引扫描)。nReturned: 查询实际返回的文档数量。totalDocsExamined: 为了找到这些文档,MongoDB总共检查了多少个文档。黄金法则: 如果
totalDocsExamined的值远远大于nReturned的值,那就说明你虽然可能用上了索引,但这索引的“效率”极低,不够精准,让数据库做了太多无用功。怎么用? 在你的查询语句后面加上
.explain('executionStats'),比如:db.users.find({city: "Beijing"}).explain('executionStats')看懂“体检报告”是关键! 在
explain()返回的一大堆信息中,你要重点关注executionStats下的这几个指标:
解决方案: 慢查询问题的核心解药,十有八九都指向了下一个“坑”——索引!
第二大“坑”:索引(Indexes)——“天堂”与“地狱”的一线之隔
索引,对于数据库来说,既是提升查询速度的“神兵利器”,也可能是拖垮写入性能的“沉重枷锁”。用好了上天堂,用不好……你懂的。
索引是“良药”:一个设计良好的索引,就像一本书的“目录”。没有目录,你得一页页翻;有了目录,你可以直奔主题。索引能让MongoDB在海量数据中,实现毫秒级的快速定位,避免
COLLSCAN。索引也是“毒药”:
“太多了,吃不消!”——过多的索引: 你每创建一个索引,MongoDB就需要额外的磁盘空间来存储它,还需要在**每一次写入操作(增、删、改)**时,去同步更新这些索引。索引越多,写入操作的开销就越大,性能就越差!
“光吃饭不干活”——无用的索引: 如果你创建了一个索引,但你的实际查询场景根本用不上它,那它就成了一个纯粹的“累赘”,只拖慢写入,不加速查询。
“用错了力”——不合适的索引: 比如,对于一个需要同时根据
city和age排序的查询,你创建的复合索引顺序却是{age: 1, city: 1},这可能就无法最高效地服务于你的查询。
如何监控与优化索引?
找出“闲置员工”——使用
$indexStats:$indexStats是MongoDB提供的一个强大的聚合管道阶段,它能告诉你每个索引的使用情况。怎么用?
db.collection.aggregate([ { $indexStats: {} } ])关注啥?
accesses.ops这个字段,它记录了这个索引自创建(或上次服务器重启)以来被查询操作使用的次数。如果这个值长期为0或者极低,那这个索引很可能就是那个“光吃饭不干活”的“闲置员工”,可以考虑果断“开除”了!监控索引的“体重”——
totalIndexSize:通过db.collection.stats()命令,可以查看到集合的详细统计信息,其中包括totalIndexSize。定期关注索引大小与数据大小(size)的比例,如果索引体积异常膨胀,就需要审视你的索引策略了。追求“极致效率”——覆盖查询(Covered Queries):这是索引优化的最高境界!如果一个查询需要的所有字段,都恰好包含在某一个索引中,那么MongoDB就可以只从索引中获取所有数据并返回,完全不需要再去读取磁盘上的原始文档。这种查询就叫“覆盖查询”,其性能极高!
第三大“坑”:复制集(Replica Set)——高可用的“生命线”也可能“打结”!
为了数据安全和高可用,我们通常会把MongoDB部署成复制集(一个Primary主节点,多个Secondary副节点)。但这根“生命线”,如果维护不当,也可能变得脆弱不堪。
核心健康指标,一个都不能少:
复制集成员之间通过心跳机制来感知彼此的存活。如果主库失联,剩下的成员会发起“选举”,投票选出新的主库。
如果你发现日志中频繁出现选举(
election)的记录,这通常是网络不稳定的强烈信号,需要立即排查复制集成员之间的网络连接质量。Oplog是主库上一个用于记录所有写操作的特殊集合。从库就是通过拉取oplog来同步数据的。oplog是“固定大小”的,写满了会覆盖旧的记录。
Oplog窗口,就是根据oplog当前的写入速度,估算出这个oplog能记录多长时间的操作日志。如果某个从库宕机或网络中断的时间,超过了这个oplog窗口,那么当它恢复时,它需要的oplog记录可能已经被主库覆盖了,此时它就无法进行增量同步,只能进行痛苦而耗时的**“完全重同步”(Initial Sync)**!
如何监控?
rs.printReplicationInfo()可以查看oplog的大小和预估的窗口时长。你需要确保这个窗口时长,足以应对你预期的最长宕机或网络中断时间。一个健康的复制集,应该有一个
PRIMARY节点,若干个SECONDARY节点。你需要持续监控每个成员的状态,如果出现RECOVERING、DOWN、UNKNOWN等异常状态,必须立即介入调查。如何监控?
rs.status()会清晰地列出每个成员的状态。这是最重要的指标! 它表示从库的数据比主库落后了多少秒。延迟过大,意味着:
如何监控? 在mongo shell中执行
rs.printSlaveReplicationInfo()或rs.status(),查看optimeDate的差异。如果主库此时宕机,你可能会丢失最近几秒甚至更久的数据!
如果你的读请求被路由到了延迟的从库,可能会读到旧数据。
“掉队了吗?”——复制延迟(Replication Lag):
“兄弟们都还在吗?”——节点状态(Member State):
“流水账”够不够长?——Oplog大小与窗口(Oplog Window):
“谁是老大?”——选举与心跳(Elections & Heartbeats):
专业的监控平台,是你的“全天候哨兵”:对于上述这些复杂的、需要持续关注的指标,手动检查显然不现实。像“
2025年MongoDB性能监控“避坑”最佳实践
监控先行,预防为主: 别等应用变慢了才想起看数据库。从项目第一天起,就把全面的数据库监控体系建立起来。
理解你的业务与查询模式: 没有“银弹”式的索引策略。最好的索引,一定是基于你应用的实际查询需求来设计的。
定期“体检”,常态化审计: 至少每个季度,对你的慢查询日志和索引使用情况进行一次全面的审计和优化。
善用云服务商的监控工具: 如果你使用的是MongoDB Atlas或其他云数据库服务,务必充分利用它们提供的内置监控、告警和性能优化建议功能。
“上下游”关联分析: 将数据库的性能指标,与你的应用性能指标(如API响应时间)、系统资源指标(CPU、内存、I/O)放在一起进行关联分析,才能更快速地定位问题的根本原因。
朋友们,MongoDB这位灵活多变的“NoSQL悍将”,在你的手中,是能削铁如泥的“屠龙宝刀”,还是反应迟钝、状况百出的“生锈铁剑”,关键就在于你是否真正读懂了它的“心”——也就是它的各项核心性能指标。
告别那些盲目的性能猜测和被动的“救火”模式吧!从今天起,用好慢查询分析、索引审计和复制集监控这三大“性能透视镜”,辅以持续、智能的监控手段,你就能让你的MongoDB集群始终保持在巅峰状态,稳如泰山地支撑起你那飞速发展的数字业务!
 豫公网安备41160202000677

