
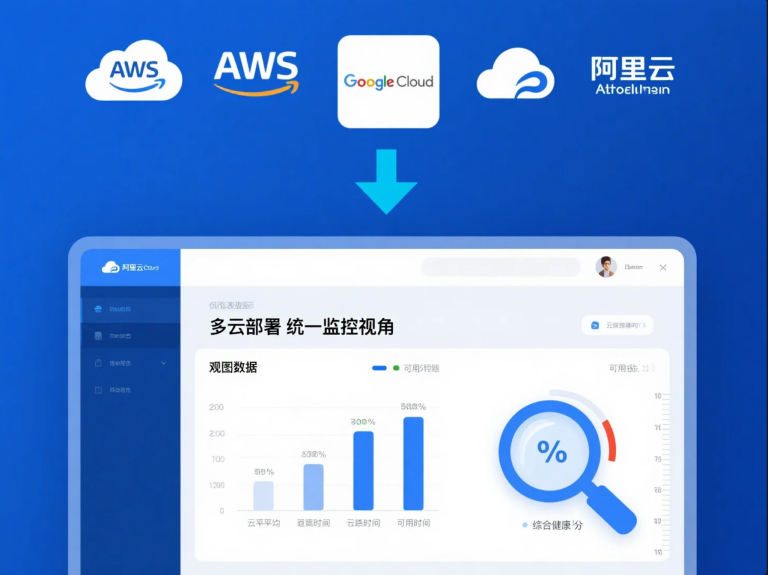
“鸡蛋不要放在同一个篮子里”,这个道理大家都懂。所以,为了追求更高的可用性、避免单一厂商锁定、利用各家云的特长,或者仅仅是历史原因,很多企业都踏上了**多云(Multi-Cloud)或混合云(Hybrid Cloud)**的征程。可能你的核心应用跑在阿里云上,AI模块用了腾讯云的GPU,海外业务则选择了AWS或Azure,甚至还有一些关键数据依然躺在本地数据中心。这听起来很美好,对吧?弹性十足,选择多多!
但随之而来的,就是运维同学的“噩梦”:监控的“七国之乱”。AWS有CloudWatch,阿里云有云监控,腾讯云有自己的监控套件……每个平台都有自己的一套指标体系、仪表盘和告警机制。当你想要评估整个对外服务的统一健康状况时,是不是感觉数据难以拉通、标准难以对齐?就像想组织一场运动会,每个代表队都用自家的秒表和计分规则,这比赛结果怎么能服众呢?
“鸡同鸭讲”的监控数据,如何破局?
在多云环境下,最大的痛点之一就是缺乏一个中立、客观、统一的视角来衡量最终用户体验。用户才不管你的服务跑在哪片“云”上,他们只关心访问快不快、功能好不好用。而你,作为服务的守护者,需要一把能跨越所有云平台边界的“通用标尺”。
这把标尺,就是外部监控。像
用外部监控给你的“多云舰队”做统一“体检”
想象一下,
“挂号”与“导航”检查 (DNS监控):
如果你用了智能DNS或全局负载均衡(GSLB)将用户流量导向不同云区的服务,那么多地域DNS监控就能告诉你:全球用户是否都能被正确、快速地“导航”到离他们最近或最健康的那个“云上服务点”?CNAME记录或A记录的解析是否稳定一致?
“码头工人”效率检查 (PING监控):
监控你各个云上服务对外的IP地址(通常是负载均衡器或网关的IP)的PING延迟和丢包率。这能帮你了解基础网络连接的健康状况,看看是不是某个云的“码头”特别拥堵。
“核心服务窗口”体验检查 (HTTP/S监控):
这是关键!针对部署在不同云上的相同或相似服务(比如你在阿里云和腾讯云上都部署了用户注册API,通过不同域名或路径对外提供),用同样的HTTP(S)监控任务(检查状态码、响应时间、TTFB、关键字内容、SSL证书)去“体检”。
横向对比: 你可以直接在
观图数据 的仪表盘上看到:“哦,从新加坡节点访问,部署在AWS新加坡区的服务平均响应50ms,而部署在阿里云香港区的同样服务是80ms。”这种苹果对苹果的比较,是各云平台自带监控很难提供的。
性能基线: 为每个云上的服务建立独立的性能基线,并持续追踪。
“安全门禁”检查 (SSL监控):
确保所有对外服务的SSL证书都有效、未过期、配置正确,无论它托管在哪家云的负载均衡器或网关后面。
“中立标尺”带来的管理价值
拥有了这把“中立标尺”,你能做什么?
客观评估云商表现: 不再只听云厂商的“一面之词”,用真实的用户端模拟数据来衡量不同云平台在你特定应用场景下的实际性能和可用性。
数据驱动的云策略: 在做服务迁移、区域扩展、或者选择新的云服务时,历史监控数据能为你提供有力的决策支持。到底哪个云在你的目标用户区域表现更好?数据说了算。
统一的SLA/SLO衡量: 无论后端服务多么复杂,你都可以基于外部监控数据,设定并追踪面向用户的、统一的服务等级目标(SLO),甚至是对外承诺的服务等级协议(SLA)。
快速故障域隔离: 当全站服务出现问题时,如果外部监控显示部署在某一个云平台上的所有服务都同时出现性能下降或错误,那问题范围就大大缩小了。
简化的运维汇报: 你可以用一套统一的图表和指标,向管理层汇报整体服务的健康状况,而不需要拼凑来自各个云平台的零散数据。
外部监控不是万能,但它是统一视角的基石
当然,我们也要清楚,外部监控主要关注的是从用户端到你服务入口的“端到端”表现。它无法深入到每个云实例内部去查看CPU使用率、内存占用、或者应用内部的错误堆栈。这些深度的、云平台内部的监控,仍然需要依赖各云厂商提供的工具或你自行部署的APM等系统。
外部监控与云原生监控,就像是“远眺”与“近观”,一个把握全局和用户体验,一个深入细节和内部机制,两者相辅相成,缺一不可。
在多云的“汪洋”中,找到你的“定盘星”
多云和混合云是大势所趋,它们带来了灵活性和选择权,但也带来了管理和监控的复杂性。在这个复杂的多云“汪洋”中,外部监控就像是你的“定盘星”和“六分仪”,为你提供了一个稳定、中立的参照系,帮助你统一衡量、客观评估、从容驾驭你的“云端舰队”。别再被不同云平台的监控仪表盘搞得晕头转向了,用
 豫公网安备41160202000677

